Waarom kunstmatige intelligentie zichzelf kan misleiden als ze te veel van andere AI leert
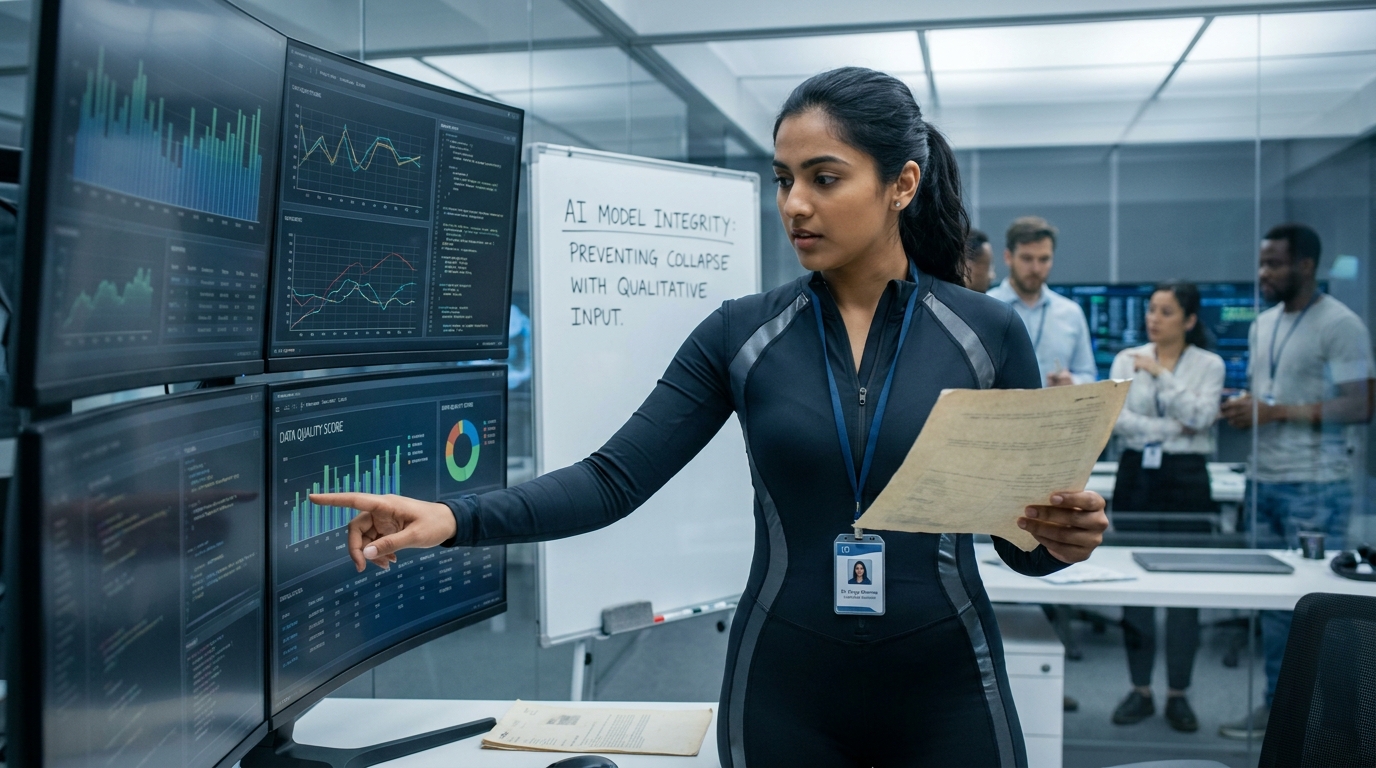
Kunstmatige intelligentie wordt steeds slimmer, sneller en krachtiger. Maar achter die indrukwekkende vooruitgang schuilt een minder zichtbaar gevaar. Wat gebeurt er wanneer AI-systemen steeds vaker worden getraind met teksten, afbeeldingen en informatie die eerder al door andere AI-systemen zijn gemaakt? Volgens onderzoekers kan dat leiden tot een fenomeen dat bekendstaat als model collapse: een proces waarbij AI langzaam maar zeker de verbinding met de echte wereld verliest.
Steeds meer wetenschappers waarschuwen dat dit geen theoretisch probleem meer is. Nu AI-gegenereerde content het internet overspoelt, groeit de kans dat toekomstige modellen vooral leren van elkaars output in plaats van van authentieke menselijke kennis.
Een kopie van een kopie verliest details
Model collapse kan worden vergeleken met het eindeloos kopiëren van een document. Elke nieuwe kopie bevat kleine foutjes of verliest subtiele details. Op zichzelf lijken die afwijkingen onschuldig, maar na tientallen generaties is het oorspronkelijke document nauwelijks nog herkenbaar.
Precies dat risico bestaat bij AI. Wanneer een model hoofdzakelijk leert van synthetische data, informatie die door andere AI is gegenereerd, kunnen kleine onnauwkeurigheden zich opstapelen. De rijkdom, nuance en diversiteit van menselijke kennis verdwijnen langzaam uit het model.
Daardoor ontstaan systemen die steeds meer op elkaar lijken, minder creatief worden en minder goed omgaan met uitzonderingen of zeldzame situaties.
Waarom synthetische data zowel een kans als een risico vormt
Synthetische data is niet per definitie slecht. Integendeel: ze speelt een belangrijke rol bij het ontwikkelen van moderne AI.
Onderzoekers gebruiken kunstmatig gegenereerde data bijvoorbeeld om:
- datasets uit te breiden wanneer echte data schaars is;
- privacygevoelige informatie te beschermen;
- zeldzame scenario's te simuleren;
- AI veiliger te trainen zonder gevoelige persoonsgegevens te gebruiken.
Het probleem ontstaat pas wanneer synthetische data de overhand krijgt en nauwelijks nog wordt gecontroleerd aan de hand van betrouwbare menselijke bronnen.
De kwaliteit van data wordt belangrijker dan de hoeveelheid
Lang gold de overtuiging dat grotere datasets automatisch betere AI opleverden. Die gedachte verandert snel.
Onderzoekers richten zich tegenwoordig steeds meer op de kwaliteit van trainingsdata. Een kleinere dataset met betrouwbare, diverse en menselijke informatie blijkt vaak waardevoller dan enorme hoeveelheden AI-gegenereerde tekst die steeds dezelfde patronen herhalen.
Vooral originele menselijke kennis, journalistieke bronnen, wetenschappelijke publicaties en gecontroleerde datasets blijven cruciaal om AI realistisch en betrouwbaar te houden.
Hoe RAG AI opnieuw met de werkelijkheid verbindt
Een van de belangrijkste technieken om model collapse tegen te gaan is Retrieval-Augmented Generation (RAG).
In plaats van uitsluitend te vertrouwen op kennis die tijdens de training is opgeslagen, zoekt een AI-systeem via RAG actuele en betrouwbare informatie op uit externe databronnen wanneer een gebruiker een vraag stelt.
Daardoor hoeft het model minder te "gissen" en kan het antwoorden baseren op gecontroleerde documenten, databases of bedrijfsinformatie. Dat verkleint niet alleen de kans op hallucinaties, maar helpt AI ook verbonden te blijven met actuele feiten.
Menselijke content blijft de fundering van betrouwbare AI
Ondanks alle vooruitgang blijft menselijke kennis onmisbaar.
Originele artikelen, wetenschappelijk onderzoek, boeken, praktijkervaringen en zorgvuldig gecontroleerde datasets vormen de basis waarop AI betrouwbare conclusies kan trekken. Zonder voortdurende aanvoer van nieuwe menselijke kennis dreigt AI zichzelf steeds vaker te voeden met bestaande AI-output, waardoor een vicieuze cirkel ontstaat.
Dat maakt kwalitatieve journalistiek, wetenschappelijk onderzoek en menselijke creativiteit belangrijker dan ooit in het AI-tijdperk.
Onderzoekers bouwen beschermingsmechanismen in
Om model collapse te voorkomen, werken onderzoekers aan verschillende strategieën:
- het zorgvuldig filteren van AI-gegenereerde trainingsdata;
- het prioriteren van menselijke en geverifieerde bronnen;
- het combineren van synthetische data met authentieke datasets;
- het toepassen van RAG om antwoorden te baseren op actuele informatie;
- voortdurende kwaliteitscontroles tijdens het trainen van nieuwe modellen.
Deze maatregelen moeten ervoor zorgen dat toekomstige AI-systemen niet gevangen raken in een gesloten informatiekringloop.
De toekomst van AI hangt af van betrouwbare kennis
Model collapse laat zien dat de grootste uitdaging voor AI niet alleen krachtigere modellen zijn, maar vooral betere informatie.
Hoe meer AI onderdeel wordt van dagelijkse besluitvorming, gezondheidszorg, wetenschap, onderwijs en bedrijfsleven, hoe belangrijker het wordt dat systemen blijven leren van de werkelijkheid in plaats van van hun eigen echo.
De komende jaren zullen daarom niet alleen draaien om grotere modellen en meer rekenkracht, maar vooral om de kwaliteit, diversiteit en betrouwbaarheid van de kennis waarop AI wordt gebouwd. Juist die menselijke basis zal bepalen of kunstmatige intelligentie een steeds nauwkeuriger beeld van de wereld ontwikkelt — of die wereld langzaam begint te vergeten.