Nieuwe inzichten tonen hoe betere datasets de toekomst van geneesmiddelen kunnen versnellen
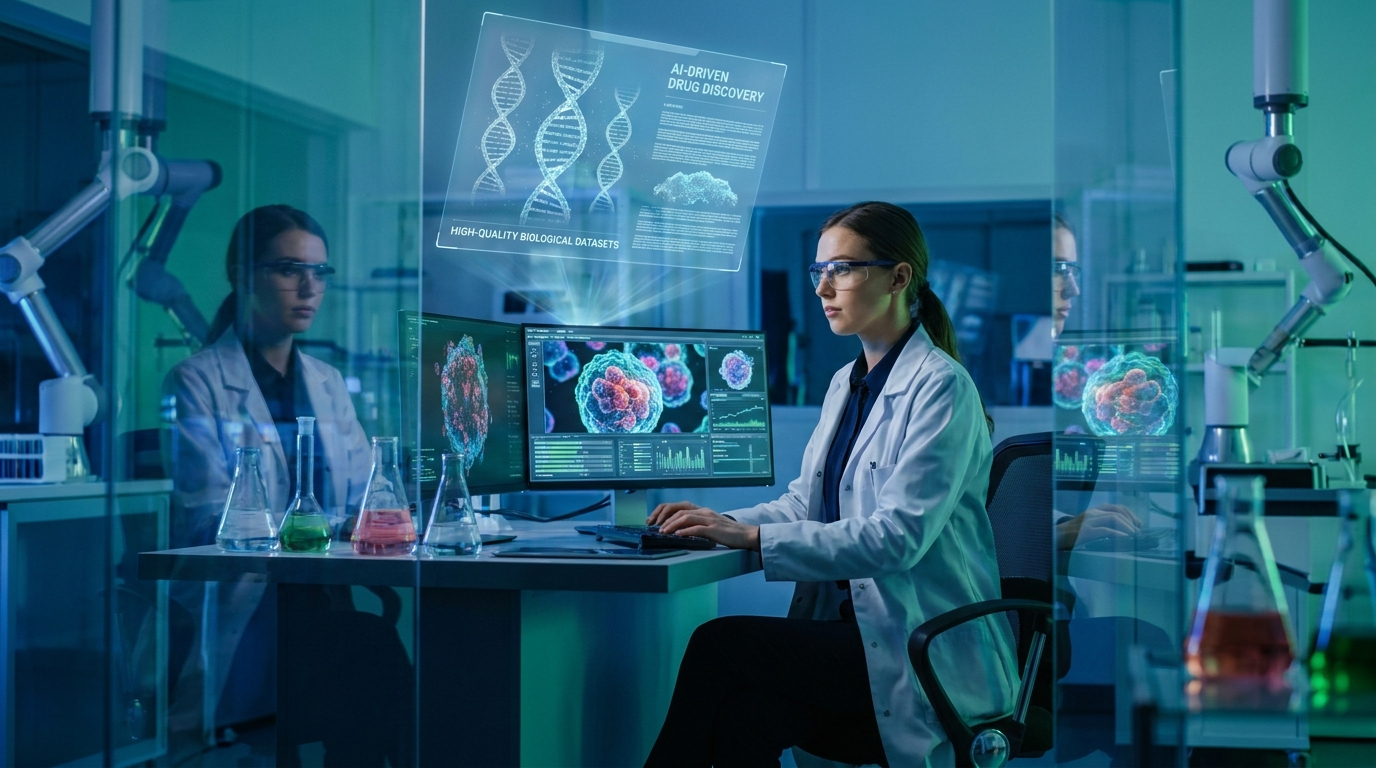
De farmaceutische industrie investeert miljarden in kunstmatige intelligentie om sneller nieuwe geneesmiddelen te ontwikkelen. Toch ligt de grootste uitdaging volgens ondernemer Yann Fleureau niet bij de AI-modellen zelf, maar bij de kwaliteit van de biologische data waarop ze worden getraind. In de Owkin Podcast legt de medeoprichter van Project Numina uit waarom experimentele biologie dringend behoefte heeft aan een nieuwe generatie datasets en waarom juist die de sleutel vormen tot de volgende doorbraak in geneesmiddelenonderzoek.
De echte bottleneck bevindt zich in het laboratorium
Hoewel AI steeds geavanceerder wordt, blijft experimentele biologie achter als het gaat om het verzamelen van betrouwbare en veelzijdige gegevens. Volgens Fleureau is het niet het ontwikkelen van slimmere algoritmen dat de grootste uitdaging vormt, maar het produceren van hoogwaardige experimentele data.
Elke nieuwe dataset vereist tijdrovende laboratoriumexperimenten, gespecialiseerde apparatuur en zorgvuldig gecontroleerde omstandigheden. Daardoor groeit de hoeveelheid bruikbare biologische informatie veel langzamer dan de snelheid waarmee AI zich ontwikkelt.
Het gevolg is dat krachtige AI-modellen vaak worden beperkt door een tekort aan representatieve en consistente trainingsgegevens.
Waarom een 'perfecte verifier' cruciaal is
Een belangrijk onderwerp in het gesprek is het concept van de zogenaamde "perfect verifier". Dat is een dataset waarvan onderzoekers met grote zekerheid weten dat de uitkomsten correct en reproduceerbaar zijn.
Zo'n dataset fungeert als een objectieve meetlat waarmee AI-modellen kunnen worden gecontroleerd, verbeterd en met elkaar vergeleken. Zonder betrouwbare verificatie is het moeilijk vast te stellen of een model daadwerkelijk biologische processen begrijpt of slechts patronen heeft geleerd die toevallig goed werken binnen een beperkte dataset.
In de wereld van AI wordt vaak gesproken over betere modellen, maar volgens Fleureau zijn betere verificatiedatasets minstens zo belangrijk.
Meer variatie in biologische experimenten
Een tweede grote uitdaging is de beperkte diversiteit van biologische experimenten. Veel huidige datasets bevatten slechts een klein deel van alle mogelijke genetische, chemische of cellulaire verstoringen.
Voor geneesmiddelenonderzoek is juist die variatie essentieel. Hoe meer verschillende biologische reacties kunnen worden gemeten, hoe beter AI leert voorspellen welke moleculen effectief zijn en welke niet.
Project Numina richt zich daarom op het drastisch vergroten van de hoeveelheid en diversiteit van zogenaamde perturbaties: gecontroleerde veranderingen die onderzoekers aanbrengen in cellen om hun gedrag beter te begrijpen.
Door miljoenen verschillende biologische reacties vast te leggen ontstaat een veel rijkere kennisbasis voor toekomstige AI-systemen.
Van taalmodellen naar biologische modellen
De ontwikkeling vertoont opvallende overeenkomsten met de evolutie van grote taalmodellen. Net zoals ChatGPT profiteerde van enorme hoeveelheden tekstdata, hebben biologische AI-modellen behoefte aan gigantische verzamelingen experimentele gegevens.
Het verschil is echter dat tekst relatief eenvoudig beschikbaar is, terwijl iedere biologische meting eerst daadwerkelijk in een laboratorium moet worden uitgevoerd.
Dat maakt de productie van hoogwaardige biologische data aanzienlijk duurder, trager en complexer.
AI als versneller van geneesmiddelenontwikkeling
Wanneer AI kan beschikken over omvangrijke en betrouwbare biologische datasets, ontstaat een fundamenteel nieuwe manier van geneesmiddelen ontwikkelen.
Onderzoekers kunnen dan veel sneller voorspellen welke moleculen kansrijk zijn, experimenten efficiënter ontwerpen en mislukte onderzoeksroutes eerder uitsluiten. Dit kan de ontwikkeltijd van nieuwe medicijnen aanzienlijk verkorten en de kosten van onderzoek terugdringen.
Volgens Fleureau ligt de toekomst daarom niet alleen in steeds intelligentere AI, maar vooral in het bouwen van een wereldwijde infrastructuur voor hoogwaardige biologische data.
Een nieuw tijdperk voor experimentele biologie
De podcast maakt duidelijk dat de volgende revolutie in AI voor de gezondheidszorg waarschijnlijk niet wordt bepaald door grotere neurale netwerken, maar door betere experimentele gegevens.
Projecten zoals Numina proberen de fundamenten te leggen voor een ecosysteem waarin biologische experimenten op veel grotere schaal kunnen worden uitgevoerd en gedeeld. Daardoor kunnen AI-systemen niet alleen sneller leren, maar ook betrouwbaarder voorspellen welke behandelingen daadwerkelijk effect zullen hebben.
Als die visie werkelijkheid wordt, kan de combinatie van experimentele biologie en kunstmatige intelligentie de ontdekking van nieuwe geneesmiddelen ingrijpend versnellen en uiteindelijk bijdragen aan een efficiëntere en meer gepersonaliseerde gezondheidszorg.