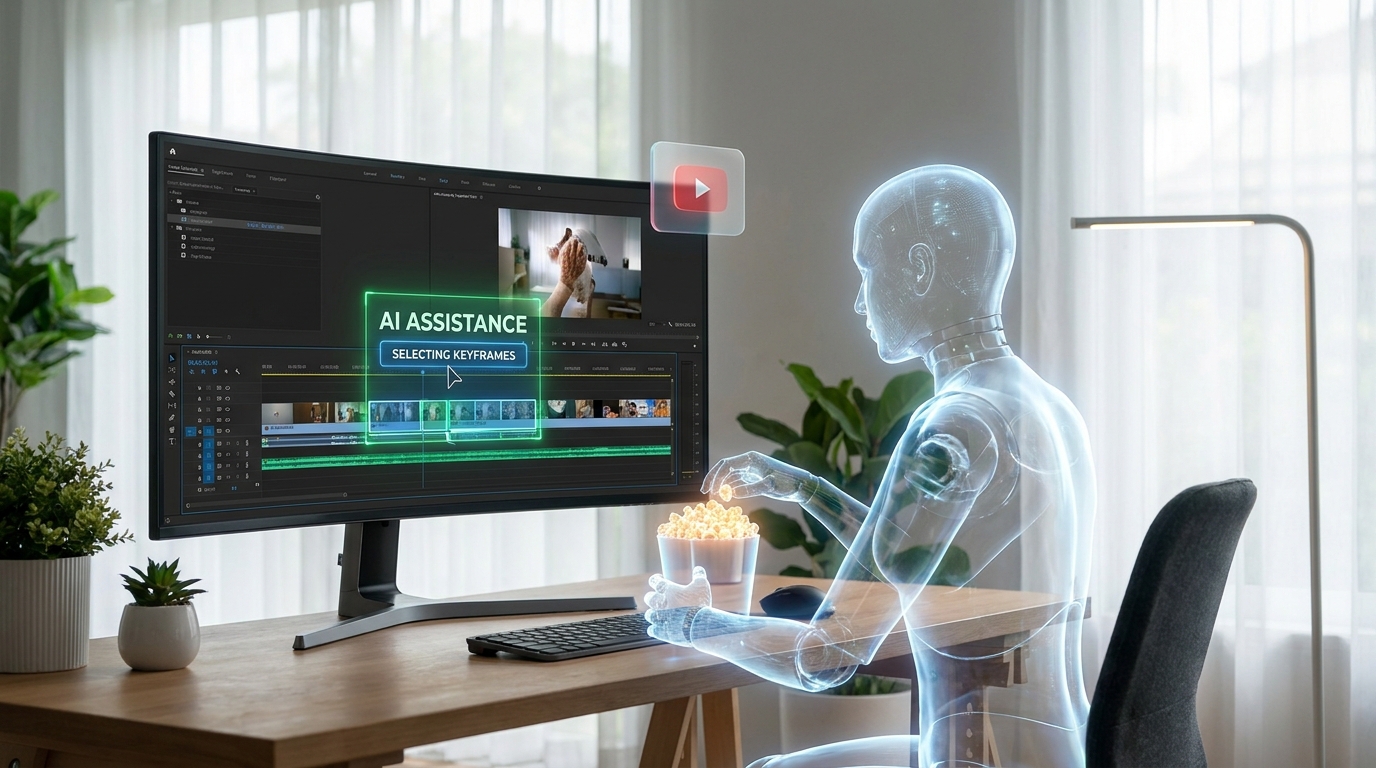
Video wordt steeds belangrijker als informatiebron voor artificiële intelligentie. Maar wie een AI-model urenlang beeldmateriaal laat analyseren, botst al snel op een praktisch probleem: een lange video kan enorme hoeveelheden tokens verbruiken. Google DeepMind probeert dat probleem op te lossen door Gemini niet simpelweg méér video te laten verwerken, maar het model slimmer te laten bepalen welke delen daadwerkelijk aandacht verdienen.
Met agentic video understanding krijgt Gemini een actievere rol tijdens de analyse. In plaats van een volledige video op dezelfde manier door te nemen, kan het systeem gericht zoeken naar relevante fragmenten, daar dieper op inzoomen en minder belangrijke stukken grotendeels links laten liggen. Het resultaat moet een efficiëntere én nauwkeurigere vorm van videobegrip worden.
Van passief kijken naar actief onderzoeken
Traditionele multimodale AI verwerkt een video doorgaans als een lange stroom informatie. Beelden, audio en andere signalen worden omgezet in representaties die vervolgens binnen de beschikbare context van het model moeten worden verwerkt.
Bij korte clips is dat relatief overzichtelijk. Bij een vergadering van twee uur, een uitgebreide productdemonstratie, een beveiligingsopname of tientallen uren onderzoeksmateriaal wordt het een ander verhaal.
Niet iedere seconde bevat immers informatie die nodig is om een bepaalde vraag te beantwoorden. Toch kan een klassiek systeem veel context besteden aan fragmenten die uiteindelijk nauwelijks relevant blijken.
Agentic video understanding probeert die verhouding om te draaien.
Gemini gaat zelf op zoek naar het antwoord
Het centrale idee is dat Gemini een video meer benadert zoals een mens dat zou doen wanneer die een specifieke vraag moet beantwoorden.
Wie bijvoorbeeld wil weten op welk moment tijdens een lange presentatie een bepaald product wordt getoond, bekijkt normaal gesproken niet minutieus iedere seconde. Die persoon scant het materiaal, zoekt naar aanwijzingen, springt naar interessante momenten en onderzoekt vervolgens het relevante fragment nauwkeuriger.
Gemini kan volgens Google DeepMind een vergelijkbare strategie toepassen. Het model redeneert over de vraag, bepaalt welke informatie daarvoor nodig is en richt vervolgens zijn aandacht op de delen van de video waar het antwoord waarschijnlijk te vinden is.
Daardoor verandert videoanalyse van een grotendeels lineair proces in een gerichte zoektocht.
Minder tokens voor informatie die er niet toe doet
Dat verschil kan belangrijk worden voor de kostprijs van multimodale AI.
Tokens functioneren als een soort rekeneenheden waarmee modellen informatie verwerken. Hoe meer informatie een systeem moet analyseren, hoe groter doorgaans de benodigde hoeveelheid tokens en rekenkracht. Bij lange video's kan dat snel oplopen. Zeker wanneer organisaties op grote schaal duizenden of zelfs miljoenen uren beeldmateriaal willen doorzoeken, wordt efficiëntie een economische factor.
De agentische aanpak probeert het tokenbudget daarom vooral te besteden aan fragmenten die relevant zijn voor de gestelde vraag. Minder interessante delen krijgen minder aandacht, terwijl cruciale scènes juist nauwkeuriger kunnen worden onderzocht.
Het principe lijkt eenvoudig: niet alles hoeft met dezelfde resolutie en dezelfde intensiteit bekeken te worden.
Efficiëntie en nauwkeurigheid hoeven geen tegenpolen te zijn
Opvallend is dat Google DeepMind de techniek niet alleen presenteert als een manier om tokens te besparen. De gerichte analyse kan tegelijkertijd de nauwkeurigheid verbeteren.
Dat klinkt aanvankelijk tegenstrijdig. Minder informatie verwerken zou immers kunnen betekenen dat het model ook meer mist.
Maar juist een enorme hoeveelheid irrelevante context kan een AI-systeem afleiden van wat werkelijk belangrijk is. Wanneer het model eerst bepaalt waar het moet zoeken en vervolgens gericht analyseert, kan het meer rekencapaciteit besteden aan de relevante momenten.
Daarmee ontstaat een bredere ontwikkeling binnen generatieve AI: intelligentie draait steeds minder uitsluitend om de omvang van een contextvenster. Minstens zo belangrijk wordt de vraag hoe een model die context gebruikt.
Video wordt een doorzoekbare informatiebron
De mogelijke toepassingen gaan veel verder dan het samenvatten van YouTube-video's.
Bedrijven beschikken bijvoorbeeld over enorme bibliotheken met webinars, trainingen, vergaderingen, instructievideo's en klanteninteracties. Mediabedrijven beheren archieven met duizenden uren audiovisueel materiaal. Fabrieken produceren camerabeelden van productieprocessen, terwijl onderzoekers experimenten steeds vaker met video documenteren.
Een agentisch systeem zou daar vragen over kunnen beantwoorden zonder ieder bestand telkens volledig en op maximale detailgraad te analyseren.
Een medewerker zou bijvoorbeeld kunnen vragen wanneer tijdens een training een bepaalde veiligheidsprocedure wordt uitgelegd. Een onderzoeker zou kunnen zoeken naar het moment waarop een specifiek verschijnsel tijdens een experiment optreedt. Een mediabedrijf zou automatisch relevante fragmenten uit een omvangrijk archief kunnen laten terugvinden.
Video verandert daarmee geleidelijk van een bestand dat bekeken moet worden in een informatiebron die bevraagd kan worden.
De AI-agent als digitale videorechercheur
De term ‘agentic’ is daarbij belangrijk. Het model krijgt niet alleen informatie aangeboden, maar kan binnen het analyseproces zelf tussenstappen bepalen.
Het onderzoekt als het ware een hypothese: waar zou het antwoord kunnen zitten? Welke fragmenten zijn interessant? Is meer detail nodig? Moet een ander moment worden bekeken?Die werkwijze komt dichter in de buurt van informatieonderzoek dan van klassieke videocompressie of eenvoudige transcriptanalyse.
Dat verschil kan uiteindelijk belangrijker blijken dan alleen de besparing op tokens. Wanneer AI-systemen zelfstandig kunnen bepalen waar ze moeten kijken, ontstaat een nieuwe categorie multimodale agents die grote hoeveelheden audiovisuele informatie doelgericht kunnen onderzoeken.
Gemini maakt van context een schaars goed
Agentic video understanding is beschikbaar binnen Gemini 3.7 Flash, 3.6 Flash en 3.5 Flash-Lite. De technologie past in een bredere verschuiving waarbij AI-ontwikkelaars steeds meer aandacht besteden aan de economie achter inference.
Grotere contextvensters hebben modellen de mogelijkheid gegeven om enorme hoeveelheden informatie tegelijk te verwerken. De volgende uitdaging is echter om die capaciteit verstandig te gebruiken. Het meest geavanceerde AI-systeem hoeft uiteindelijk niet het systeem te zijn dat alles bekijkt. Het kan juist het systeem zijn dat begrijpt wat het niet hoeft te bekijken.
Met agentic video understanding probeert Gemini precies die stap te zetten. Lange video's worden niet langer behandeld als één gigantische stroom tokens, maar als een landschap waarin een AI-agent zelfstandig naar relevante informatie kan zoeken. En daarmee krijgt ‘video begrijpen’ een nieuwe betekenis: niet langer ieder beeld verwerken, maar weten waar het antwoord verborgen zit.