Wanneer traditionele software faalt, levert dat meestal een duidelijke foutmelding of een gecrashte server op. Bij complexe AI-systemen en taalmodellen (LLM's) ligt dat anders: een AI-agent kan een volstrekt verkeerd antwoord geven, vastlopen in een doelloze herhaling of verkeerde keuzes maken, terwijl het systeem 'op papier' gewoon naar behoren functioneert.
In een recente toelichting over AI-observabiliteit legt Legare Kerrison uit hoe MLflow helpt om deze verborgen fouten op te sporen en te corrigeren binnen geavanceerde multi-agent systemen.
De uitdaging van de blinde vlek
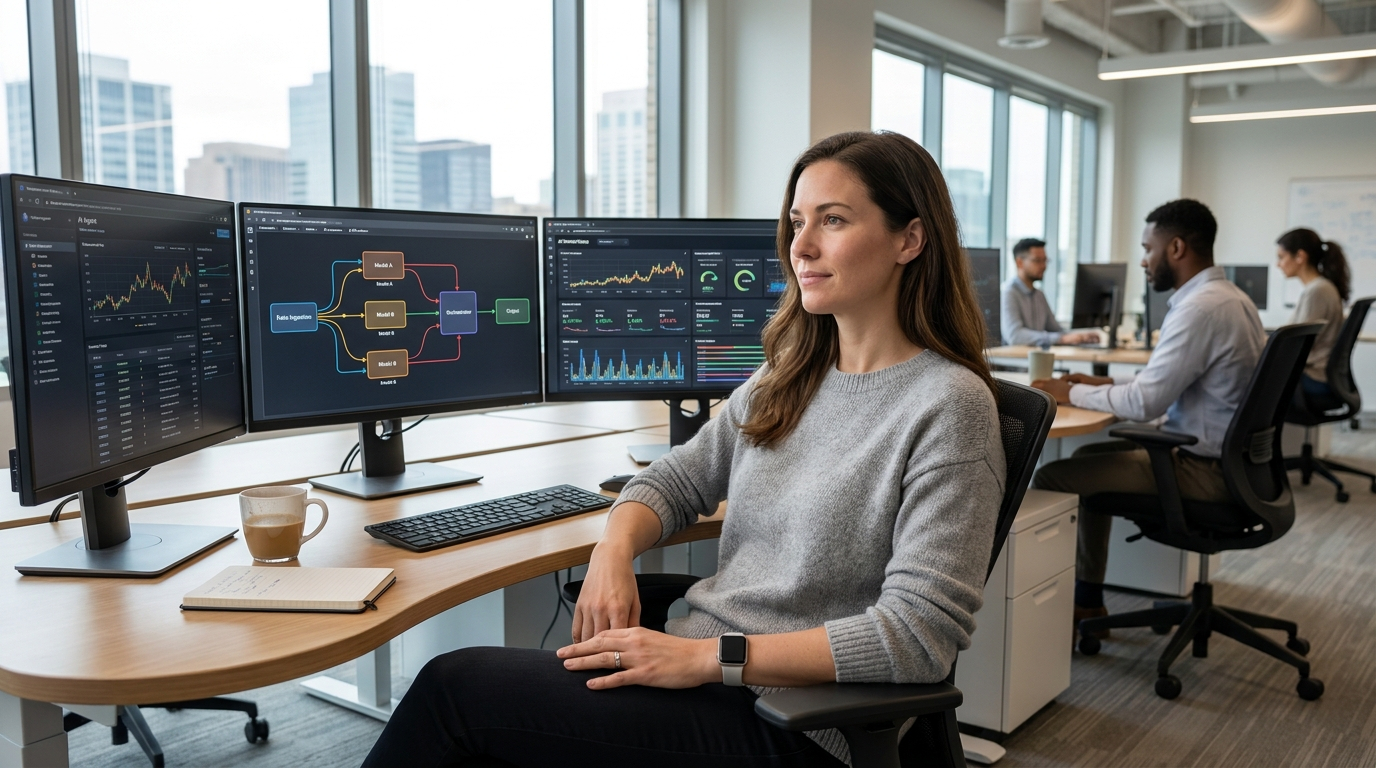
Traditionele monitoring meet zaken zoals responstijden en geheugengebruik, maar heeft geen zicht op de inhoudelijke redenering van een AI-model. Wanneer meerdere AI-agenten met elkaar samenwerken, ontstaat er een ingewikkeld web van interacties. Als het eindresultaat niet klopt, is het zonder de juiste tools vrijwel onmogelijk te achterhalen welke specifieke agent de fout in is gegaan.
Tracing en OpenTelemetry in de praktijk
Om deze blinde vlek op te heffen, maakt MLflow gebruik van tracing en open standaarden zoals OpenTelemetry. Hiermee wordt elke stap in de workflow van een AI-agent nauwkeurig vastgelegd. Ontwikkelaars kunnen precies zien:
- Welke specifieke prompts naar het model zijn gestuurd;
- Welke externe tools of databases de AI heeft geraadpleegd;
- Hoe de besluitvorming tussen verschillende sub-agents is verlopen.
LLM-beoordelaars en continue evaluatie
Naast het in kaart brengen van de datastroom (tracing), belicht Kerrison het belang van geautomatiseerde evaluatieworkflows. Door zogenaamde 'LLM-judges' (taalmodellen die worden ingezet om de output van andere modellen te beoordelen) te combineren met gestructureerde testmethodes, kunnen organisaties de nauwkeurigheid en betrouwbaarheid van hun AI-systemen continu meten.
Het resultaat is een robuuste monitoringomgeving die ervoor zorgt dat AI-toepassingen niet alleen snel werken, maar bovenal inhoudelijk correct en veilig blijven functioneren.